雨晴 LLM2026官方最新版本
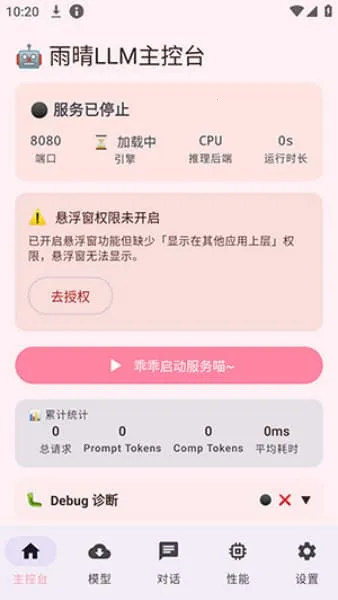
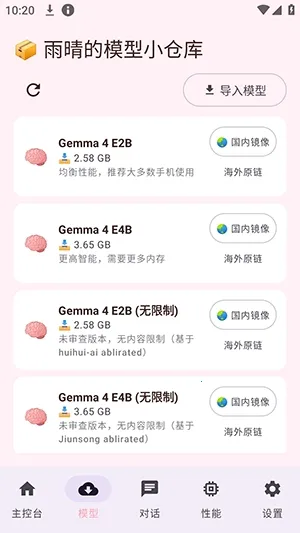
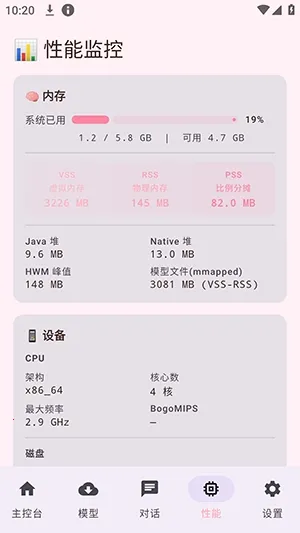
雨晴LLM2026官方最新版本是运行于安卓的本地离线LLM推理服务器。功能超实用,CPU与GPU推理后端能自由切换,有实时性能统计仪表板和可拖动悬浮窗口。使用时先安装APK并授权,下载模型文件,选推理后端启动服务,用兼容客户端填本地地址即可调用。优势是支持持久后台服务,模型可单独下载,兼容OpenAI接口。适配人群为想在本地离线运行AI程序的用户。
雨晴 LLM2026官方最新版本点评
雨晴LLM为Android平台本地离线推理服务器,配套功能完善。支持CPU与GPU推理后端切换,有实时性能统计仪表板监控负载,可拖动悬浮窗口方便调控服务,还有持久后台服务。其特色在于模型独立下载,兼容OpenAI接口格式。使用时安装APK授予权限,下载模型文件,选择推理后端启动服务即可。亮点是能自定义基础推理参数,优化资源调度,支持多客户端接入,如手机作家庭离线AI中枢供多终端调用,满足多样需求,提升使用体验。
雨晴 LLM2026官方最新版本特色
1. 支持多推理后端自由切换:可依据手机硬件配置及功耗需求,在CPU与GPU推理后端间自主抉择,兼顾老旧设备与高性能机型的不同使用场景。
2. 配备实时性能统计仪表板:能可视化展示推理速度、内存占用、负载状态等运行数据,方便用户监控模型运行,及时调整参数优化表现。
3. 支持持久后台服务模式:启动推理服务后可切至后台持续运行,不因页面退出中断任务,稳定为外部客户端提供AI接口服务。
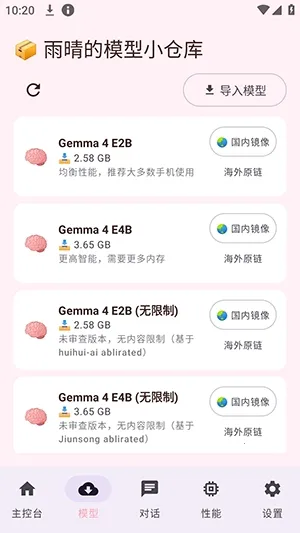
4. 模型独立下载机制灵活:用户按需获取对应量化规格的Gemma权重文件导入,不强制捆绑内置模型,平衡存储空间与推理效果。
怎么使用
1、安装 APK,授予存储、后台悬浮窗、后台运行权限;
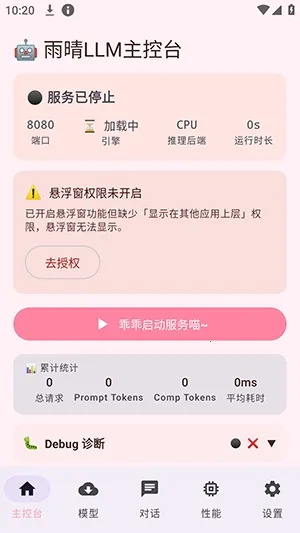
2、进入模型管理页面,下载对应 Gemma量化模型文件;
3、选择 CPU/GPU推理后端,启动本地 API服务;
4、使用任意兼容 OpenAI API的客户端,填写本地地址 http://127.0.0.1:8080即可调用;
5、悬浮窗可随时查看生成进度、切换模型、关闭服务。
雨晴 LLM2026官方最新版本亮点
1. 支持多客户端接入:局域网内其他设备可访问推理接口,手机能作为家庭离线AI中枢,供多终端调用大模型能力。
2. 优化资源调度:后台推理时管控功耗与内存占用,减少卡顿闪退,延长离线推理任务持续运行时长。
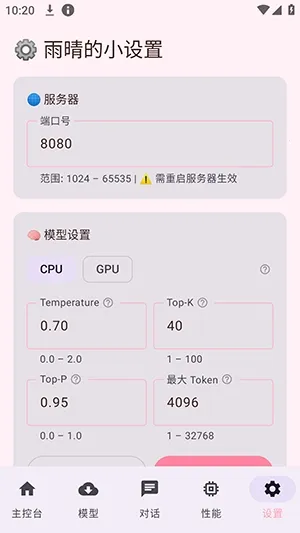
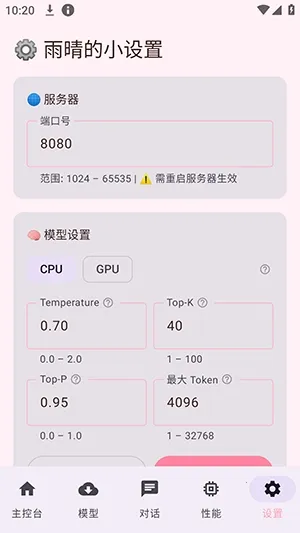
3. 基础推理参数自定义:可调整温度、上下文长度等配置,适配不同任务需求。